
Spark(5):RDD概述
创始人
2024-05-30 16:11:13
0次
目录
0. 相关文章链接
1. 什么是RDD
2. RDD核心属性
3. 执行原理
0. 相关文章链接
Spark文章汇总
1. 什么是RDD
RDD(Resilient Distributed Dataset)叫做弹性分布式数据集,是 Spark 中最基本的数据处理模型。代码中是一个抽象类,它代表一个弹性的、不可变、可分区、里面的元素可并行计算的集合。
- 弹性:
- 存储的弹性:内存与磁盘的自动切换;
- 容错的弹性:数据丢失可以自动恢复;
- 计算的弹性:计算出错重试机制;
- 分片的弹性:可根据需要重新分片;
- 分布式:数据存储在大数据集群不同节点上
- 数据集:RDD 封装了计算逻辑,并不保存数据
- 数据抽象:RDD 是一个抽象类,需要子类具体实现
- 不可变:RDD 封装了计算逻辑,是不可以改变的,想要改变,只能产生新的 RDD,在新的RDD 里面封装计算逻辑
- 可分区、并行计算
2. RDD核心属性
- 分区列表:RDD 数据结构中存在分区列表,用于执行任务时并行计算,是实现分布式计算的重要属性。
- 分区计算函数:Spark 在计算时,是使用分区函数对每一个分区进行计算
- RDD 之间的依赖关系:RDD 是计算模型的封装,当需求中需要将多个计算模型进行组合时,就需要将多个 RDD 建立依赖关系
- 分区器(可选):当数据为 KV 类型数据时,可以通过设定分区器自定义数据的分区
- 首选位置(可选):计算数据时,可以根据计算节点的状态选择不同的节点位置进行计算
3. 执行原理
从计算的角度来讲,数据处理过程中需要计算资源(内存 & CPU)和计算模型(逻辑)。执行时,需要将计算资源和计算模型进行协调和整合。
Spark 框架在执行时,先申请资源,然后将应用程序的数据处理逻辑分解成一个一个的计算任务。然后将任务发到已经分配资源的计算节点上, 按照指定的计算模型进行数据计算。最后得到计算结果。
RDD 是 Spark 框架中用于数据处理的核心模型,在 Yarn 环境中,RDD的工作原理如下所示:
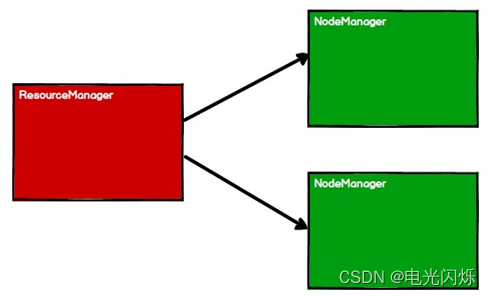
1) 启动 Yarn 集群环境
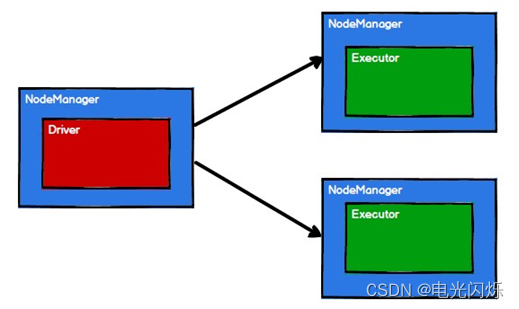
2) Spark 通过申请资源创建调度节点和计算节点
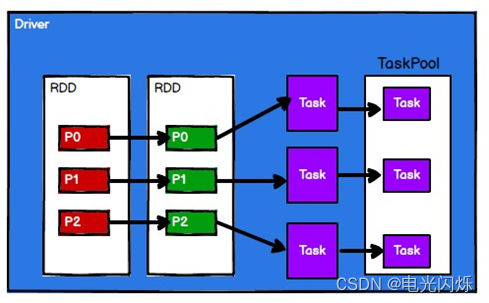
3) Spark 框架根据需求将计算逻辑根据分区划分成不同的任务
4) 调度节点将任务根据计算节点状态发送到对应的计算节点进行计算
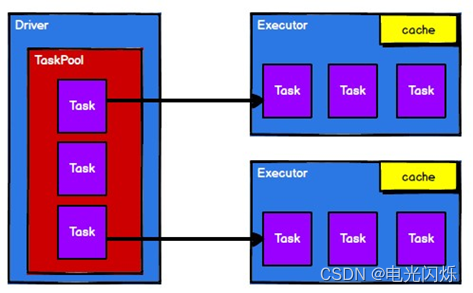
从以上流程可以看出 RDD 在整个流程中主要用于将逻辑进行封装,并生成 Task 发送给 Executor 节点执行计算。
注:其他Spark相关系列文章链接由此进 -> Spark文章汇总
相关内容
热门资讯
前端-session、jwt
目录: (1)session (2&#x...
linux入门---制作进度条
了解缓冲区 我们首先来看看下面的操作: 我们首先创建了一个文件并在这个文件里面添加了...
关于测试,我发现了哪些新大陆
关于测试 平常也只是听说过一些关于测试的术语,但并没有使用过测试工具。偶然看到编程老师...
前缀和与对数器与二分法
1. 前缀和 假设有一个数组,我们想大量频繁的去访问L到R这个区间的和,...
nodejs:本地安装nvm实...
一、背景-使用不同版本node的原因 vue3+ts、nuxt3版本,node...
JAVA集合知识整理
Java集合知识整理 HashMap相关 HashMap的底层数据结构:jdk1.8之...
无刷直流电机介绍及单片机控制实...
无刷直流电机介绍及单片机控制实例前言基本概念优势与劣势使用寿命基本结构使用单片机控制实例电子调速器&...
fwdiary(2) dp2
1.传纸条 AcWing 275. 传纸条 - AcWing 走两条路,走一条最大的...
常用的DOS命令
常用的DOS命令 DOS(Disk Operating System,磁...
<C++> 类和对象(下)
1.const成员函数将const修饰的“成员函数”称之为const成员函数,cons...