
编译原理个人作业--第二章
第二章
6
文法G6G_6G6为
N→D∣NDN\rightarrow D|NDN→D∣ND
d→0∣1∣2∣3∣4∣5∣6∣7∣8∣9d\rightarrow 0|1|2|3|4|5|6|7|8|9d→0∣1∣2∣3∣4∣5∣6∣7∣8∣9
6.1
首先L(G)L(G)L(G)表示文法G产生的全部句子的集合 —— 语言
不难发现,由递归的定义
L(G6)={D,DD,DDD,DDDD...}L(G_6) = \{D, DD, DDD, DDDD ...\}L(G6)={D,DD,DDD,DDDD...}
将上述的D全部换成数字字符
得到的便是数字字符串全体
6.2
给出句子012、 34、 568最左推导和最右推导
先明确定义:
- 最左推导:任何一步α⇒β\alpha \Rightarrow \betaα⇒β都是对α\alphaα中的最左非终结符进行替换。
N⇒ND⇒NDD⇒NDDD⇒DDDD⇒0DDD⇒01DD⇒012D⇒0127N \Rightarrow ND \Rightarrow NDD \Rightarrow NDDD \Rightarrow DDDD \\ \Rightarrow 0DDD \Rightarrow 01DD \Rightarrow 012D \Rightarrow 0127N⇒ND⇒NDD⇒NDDD⇒DDDD⇒0DDD⇒01DD⇒012D⇒0127
N⇒ND⇒DD⇒3D⇒34N \Rightarrow ND \Rightarrow DD \Rightarrow 3D \Rightarrow 34 N⇒ND⇒DD⇒3D⇒34
N⇒ND⇒NDD⇒DDD⇒5DD⇒56D⇒568N \Rightarrow ND \Rightarrow NDD \Rightarrow DDD \Rightarrow 5DD \Rightarrow 56D \Rightarrow 568 N⇒ND⇒NDD⇒DDD⇒5DD⇒56D⇒568
- 最右推导:任何一步任何一步α⇒β\alpha \Rightarrow \betaα⇒β都是对α\alphaα中的最右非终结符进行替换。也称规范推导(canonical derivations)。
N⇒ND⇒N7⇒ND7⇒N27⇒ND27⇒N127⇒D127⇒0127N \Rightarrow ND \Rightarrow N7 \Rightarrow ND7 \Rightarrow N27 \\\Rightarrow ND27 \Rightarrow N127 \Rightarrow D127 \Rightarrow 0127N⇒ND⇒N7⇒ND7⇒N27⇒ND27⇒N127⇒D127⇒0127
N⇒ND⇒N4⇒D4⇒34N \Rightarrow ND \Rightarrow N4 \Rightarrow D4 \Rightarrow 34 N⇒ND⇒N4⇒D4⇒34
N⇒ND⇒N8⇒ND8⇒N68⇒D68⇒568N \Rightarrow ND \Rightarrow N8 \Rightarrow ND8 \Rightarrow N68 \Rightarrow D68 \Rightarrow 568 N⇒ND⇒N8⇒ND8⇒N68⇒D68⇒568
7
写一个文法让他的语言为十进制表示的正奇数集,不以0开头
S→O∣NON→NP∣1∣2∣3∣4∣5∣6∣7∣8∣9P→0∣1∣2∣3∣4∣5∣6∣7∣8∣9O→1∣3∣5∣7∣9S\rightarrow O |NO\\ N\rightarrow NP |1|2|3|4|5|6|7|8|9\\ P\rightarrow 0|1|2|3|4|5|6|7|8|9\\ O\rightarrow1|3|5|7|9S→O∣NON→NP∣1∣2∣3∣4∣5∣6∣7∣8∣9P→0∣1∣2∣3∣4∣5∣6∣7∣8∣9O→1∣3∣5∣7∣9
8
文法为
E→T∣E+T∣E−TT→F∣T∗F∣T/FF→(E)∣iE\rightarrow T | E + T| E-T\\ T\rightarrow F|T*F|T/F\\ F\rightarrow (E)|iE→T∣E+T∣E−TT→F∣T∗F∣T/FF→(E)∣i
8.1
给出 i+i*i和i*(i+i)最左推导和最右推导
- 最左推导
E⇒E+T⇒T+T⇒F+T⇒i+T⇒i+T∗F⇒i+F∗F⇒i+i∗F⇒i+i∗iE \Rightarrow E + T\Rightarrow T + T \Rightarrow F + T \Rightarrow i + T \\\Rightarrow i + T * F \Rightarrow i + F * F \Rightarrow i + i * F \Rightarrow i + i * i E⇒E+T⇒T+T⇒F+T⇒i+T⇒i+T∗F⇒i+F∗F⇒i+i∗F⇒i+i∗i
E⇒T⇒T∗F⇒F∗F⇒i∗F⇒i∗(E)⇒i∗(E+T)⇒i∗(T+T)⇒i∗(F+T)⇒i∗(i+T)⇒i∗(i+F)⇒i∗(i+i)E \Rightarrow T \Rightarrow T * F \Rightarrow F * F \Rightarrow i * F \Rightarrow i * (E) \Rightarrow i * (E + T) \\\Rightarrow i * (T + T) \Rightarrow i * (F + T) \Rightarrow i * (i + T) \Rightarrow i * (i + F) \Rightarrow i * (i + i)E⇒T⇒T∗F⇒F∗F⇒i∗F⇒i∗(E)⇒i∗(E+T)⇒i∗(T+T)⇒i∗(F+T)⇒i∗(i+T)⇒i∗(i+F)⇒i∗(i+i)
- 最右推导
E⇒E+T⇒E+T∗F⇒E+T∗i⇒E+F∗i⇒E+i∗i⇒T+i∗i⇒F+i∗i⇒i+i∗iE \Rightarrow E + T \Rightarrow E + T * F \Rightarrow E + T * i \Rightarrow E + F * i \Rightarrow E + i * i \\\Rightarrow T + i * i \Rightarrow F + i * i \Rightarrow i + i * iE⇒E+T⇒E+T∗F⇒E+T∗i⇒E+F∗i⇒E+i∗i⇒T+i∗i⇒F+i∗i⇒i+i∗i
E⇒T⇒T∗F⇒T∗(E)⇒T∗(E+T)⇒T∗(E+F)⇒T∗(E+i)⇒T∗(T+i)⇒T∗(F+i)⇒T∗(i+i)⇒F∗(i+i)⇒i∗(i+i)E \Rightarrow T \Rightarrow T * F \Rightarrow T * (E) \Rightarrow T * (E + T) \Rightarrow T * (E + F) \Rightarrow T * (E + i)\\ \Rightarrow T * (T + i) \Rightarrow T * (F + i) \Rightarrow T * (i + i)\Rightarrow F * (i + i) \Rightarrow i * (i + i)E⇒T⇒T∗F⇒T∗(E)⇒T∗(E+T)⇒T∗(E+F)⇒T∗(E+i)⇒T∗(T+i)⇒T∗(F+i)⇒T∗(i+i)⇒F∗(i+i)⇒i∗(i+i)
8.1
给出 i+i+i、i+i*i、i-i-i的语法树
以最左推导生成
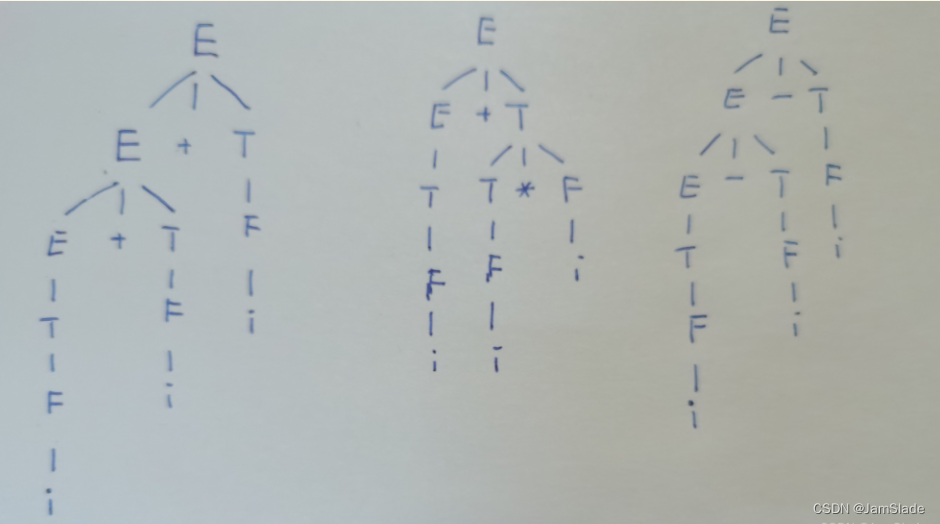

9
证明文法二义
S→iSeS∣iS∣iS\rightarrow iSeS|iS|iS→iSeS∣iS∣i
- 如果一个文法存在某个句子对应两颗不同的语法树,则说这个文法是二义的
于是我们可以从最左推导和最右推导出相同的句子
最左
S⇒iSeS⇒iiSeS⇒iiieS⇒iiieiS\Rightarrow iSeS \Rightarrow iiSeS \Rightarrow iiieS \Rightarrow iiieiS⇒iSeS⇒iiSeS⇒iiieS⇒iiiei
最右推导
S⇒iS⇒iiSeS⇒iiSei⇒iiieiS\Rightarrow iS \Rightarrow iiSeS \Rightarrow iiSei \Rightarrow iiieiS⇒iS⇒iiSeS⇒iiSei⇒iiiei
对应的语法树完全不一样
所以具有二义性
10
文法改写为无二义的
S→SS∣(S)∣()S\rightarrow SS|(S)|()S→SS∣(S)∣()
表示有效括号的所有生成
这里由于S在右侧出现了两次,导致最右推导和最左推导生成的语法树可能会不一致,所以应把SS拆分
S→AS∣AA→(S)∣()S\rightarrow AS|A\\ A\rightarrow (S)|() S→AS∣AA→(S)∣()
将括号内部的生成完全隔离
还可以写成如下形式
S→SA∣AA→(S)∣()S\rightarrow SA|A\\ A\rightarrow (S)|() S→SA∣AA→(S)∣()
11
给出语言的相应文法
L1={anbnci∣n≥1,i≥0}L2={aibncn∣n≥1,i≥0}L3={anbnambm∣n,m≥0}L4={1n0m1m0n∣n,m≥0}L_1 = \{a^nb^nc^i|n\ge 1, i\ge 0\}\\ L_2 = \{a^ib^nc^n|n\ge 1, i\ge 0\}\\ L_3 = \{a^nb^n a^mb^m|n,m\ge 0\}\\ L_4 = \{1^n0^m 1^m0^n|n,m\ge 0\} L1={anbnci∣n≥1,i≥0}L2={aibncn∣n≥1,i≥0}L3={anbnambm∣n,m≥0}L4={1n0m1m0n∣n,m≥0}
L1
或者
S→BCB→AbA→aB∣aC→CC∣c∣ϵS\rightarrow BC\\ B\rightarrow Ab \\ A\rightarrow aB|a\\ C \rightarrow CC|c|\epsilon S→BCB→AbA→aB∣aC→CC∣c∣ϵ
可以稍微精简一下
S→BCB→ab∣aBbC→Cc∣ϵS\rightarrow BC\\ B\rightarrow ab|aBb \\ C \rightarrow Cc|\epsilon S→BCB→ab∣aBbC→Cc∣ϵ
L2
S→ACC→BcB→b∣bCA→Aa∣ϵS\rightarrow AC\\ C\rightarrow Bc \\ B\rightarrow b|bC\\ A \rightarrow Aa|\epsilon S→ACC→BcB→b∣bCA→Aa∣ϵ
也可以把B和C精简成
C→bc∣bCcC\rightarrow bc|bCcC→bc∣bCc
L3
S→LRL→aLb∣ϵR→aRb∣ϵS\rightarrow LR\\ L\rightarrow aLb| \epsilon\\ R\rightarrow aRb| \epsilonS→LRL→aLb∣ϵR→aRb∣ϵ
L4
S→ϵ∣BB→1B0∣DD→0D1∣ϵS\rightarrow \epsilon | B\\ B\rightarrow 1B0|D\\ D \rightarrow 0D1|\epsilon S→ϵ∣BB→1B0∣DD→0D1∣ϵ
检查发现貌似第一步S→ϵS\rightarrow \epsilonS→ϵ可以省略掉
S→BB→1B0∣DD→0D1∣ϵS\rightarrow B\\ B\rightarrow 1B0|D\\ D \rightarrow 0D1|\epsilon S→BB→1B0∣DD→0D1∣ϵ
感觉可以直接把S和B看作同一个东西,继续化简
S→1S0∣DD→0D1∣ϵS\rightarrow 1S0|D\\ D \rightarrow 0D1|\epsilon S→1S0∣DD→0D1∣ϵ